Инструменты · 16 октября 2026 г.
Что такое Jev и как им пользоваться
Jev от TypeSafe AI классифицирует данные, выбирает варианты и оценивает их по заданной шкале. Разбираем, как попробовать модель в браузере и подключить к приложению.
Что такое Jev и где он пригодится
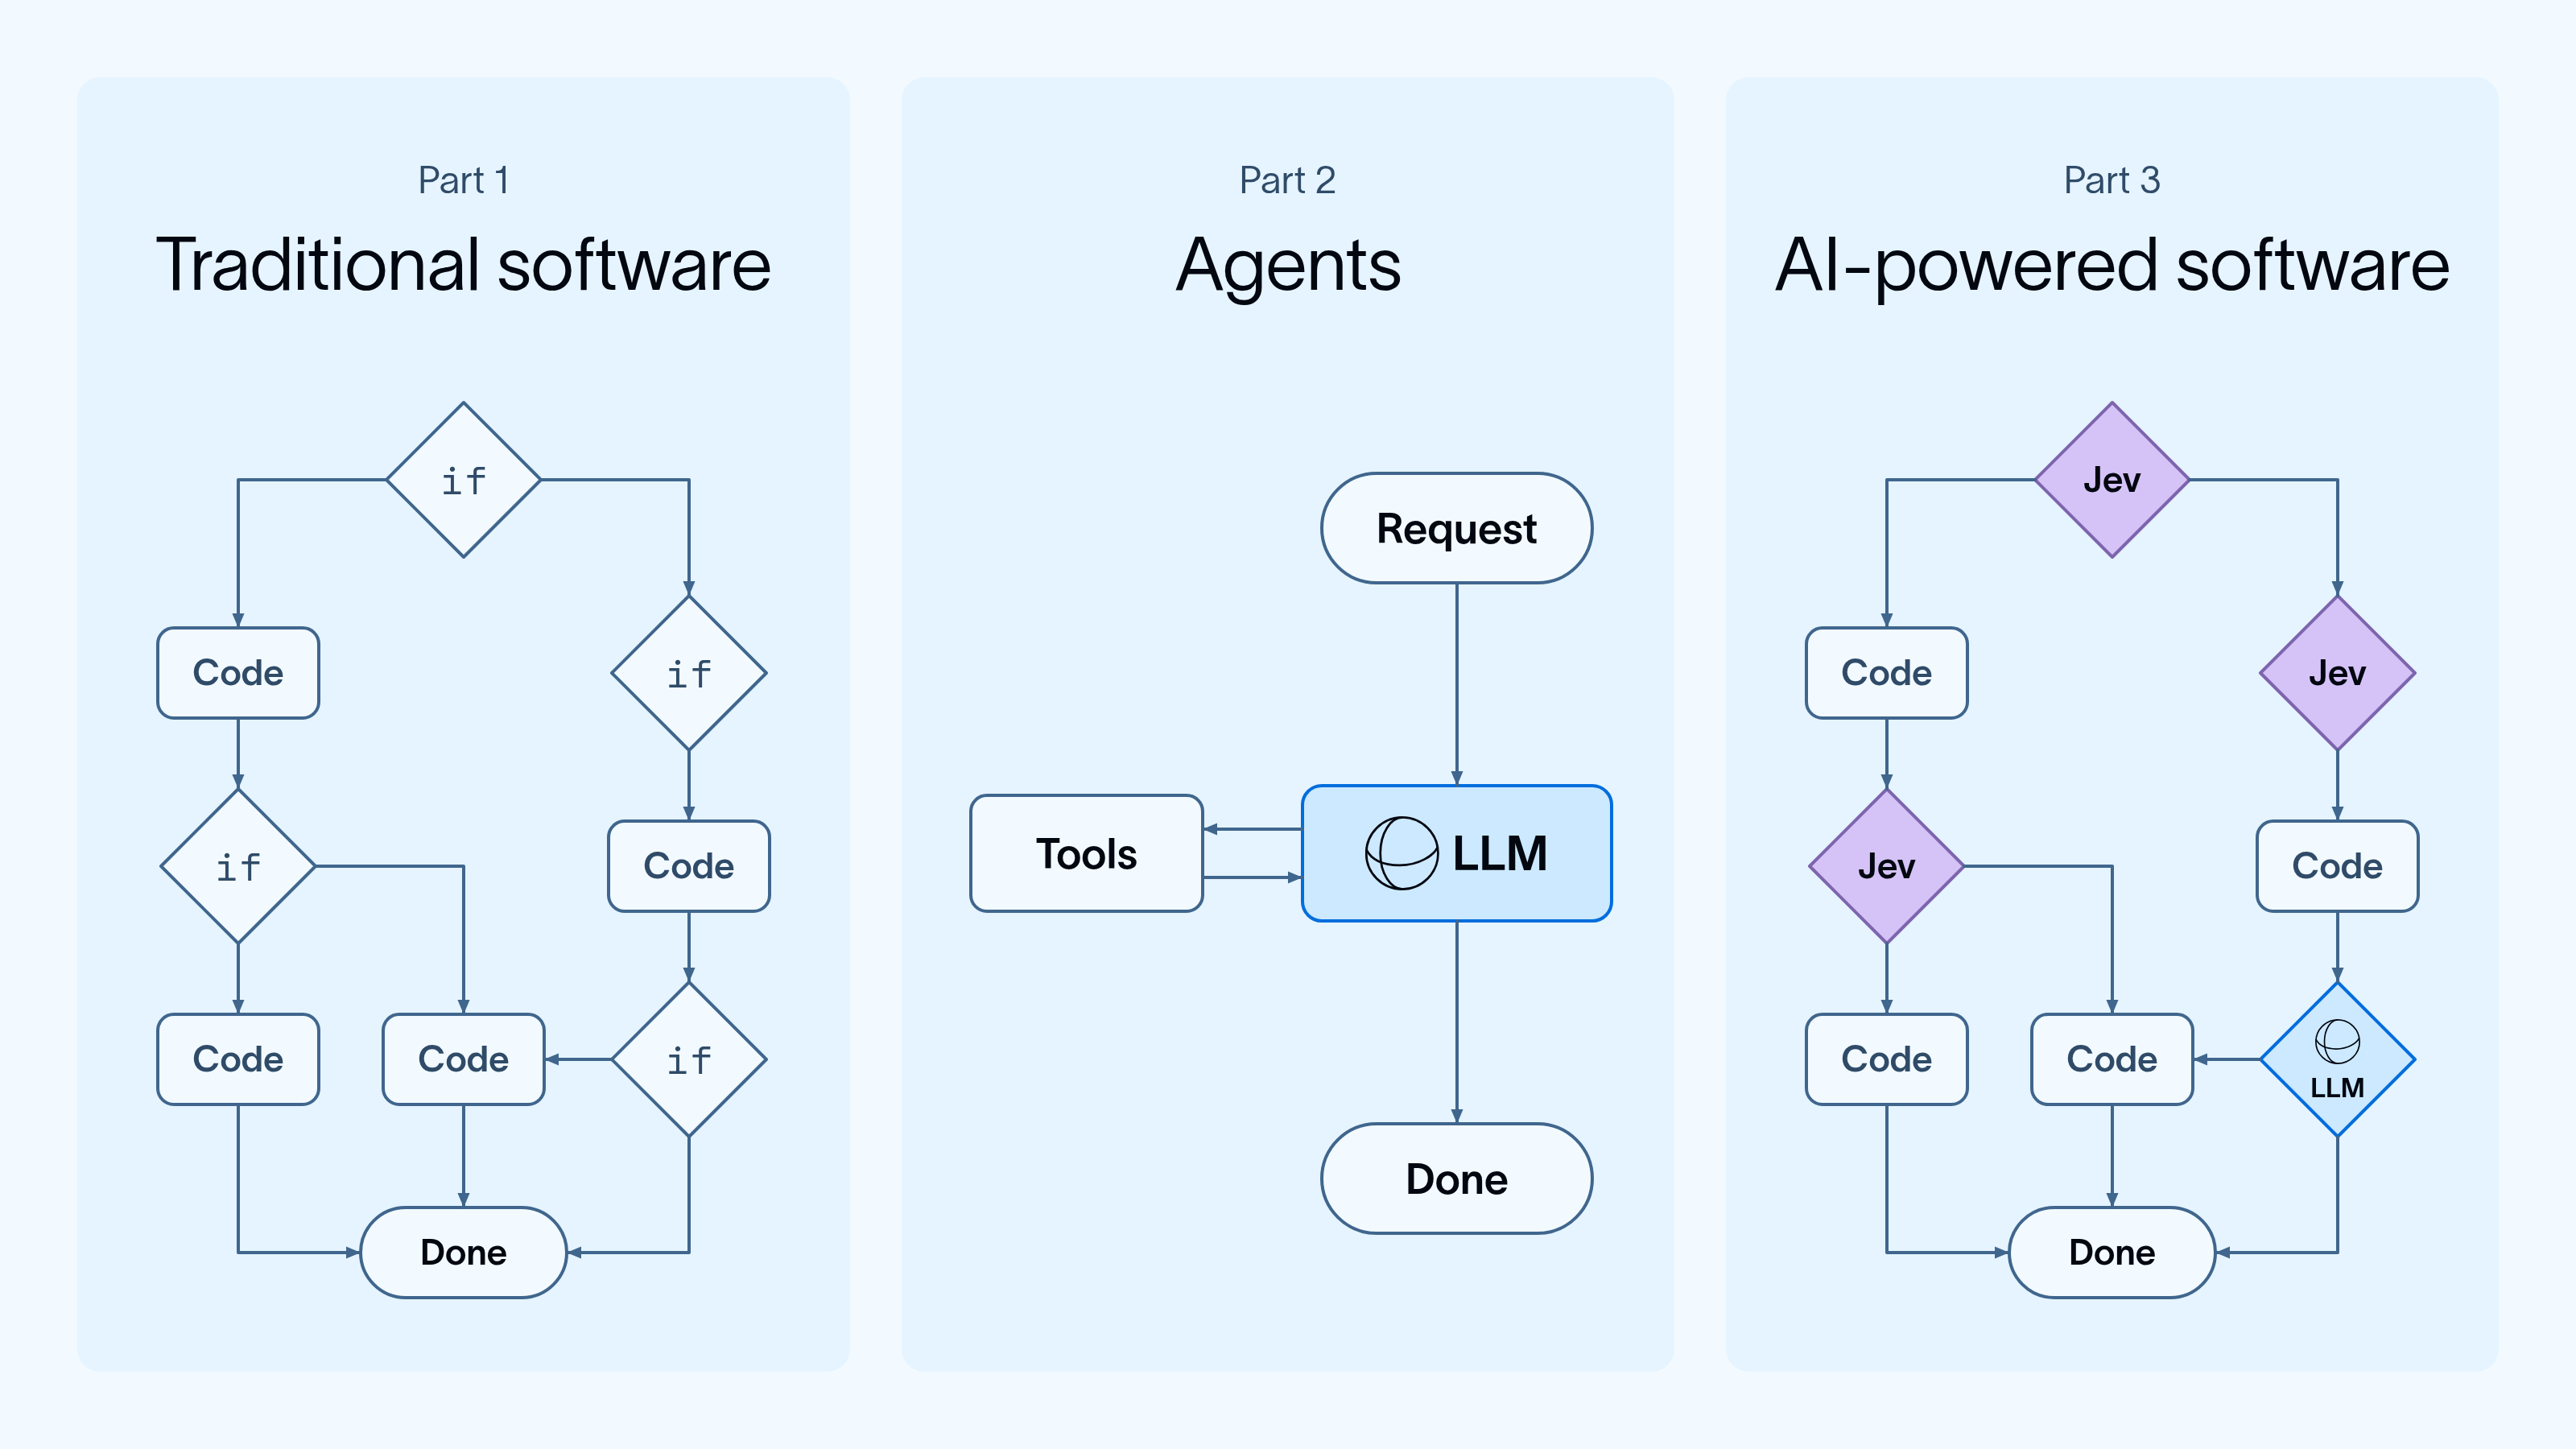
Jev — модель TypeSafe AI, которая принимает данные и вопросы с заданным форматом ответа. Она может определить категорию обращения, оценить серьёзность ошибки или выбрать следующий инструмент для агента. В документации TypeSafe такой подход называется System One: программа получает типизированные значения и вероятности, с которыми можно работать в обычном коде.
Представим службу поддержки, которая получает письмо о двойном списании. Jev можно поручить выбор категории «платежи», а приложению — отправку обращения нужной команде. Объяснение для клиента затем пишет человек или языковая модель. Jev сам не ведёт диалог и не пишет код; TypeSafe отдельно объясняет, что заменить им модель внутри Cursor или Claude Code нельзя.
В разборе LangChain показан похожий принцип для проверки документов: Jev классифицирует страницы, а отдельные ветки процесса передают их на редактирование LLM или на проверку человеку. Разработчик задаёт порядок действий и условия переходов.
Какие вопросы можно задавать модели
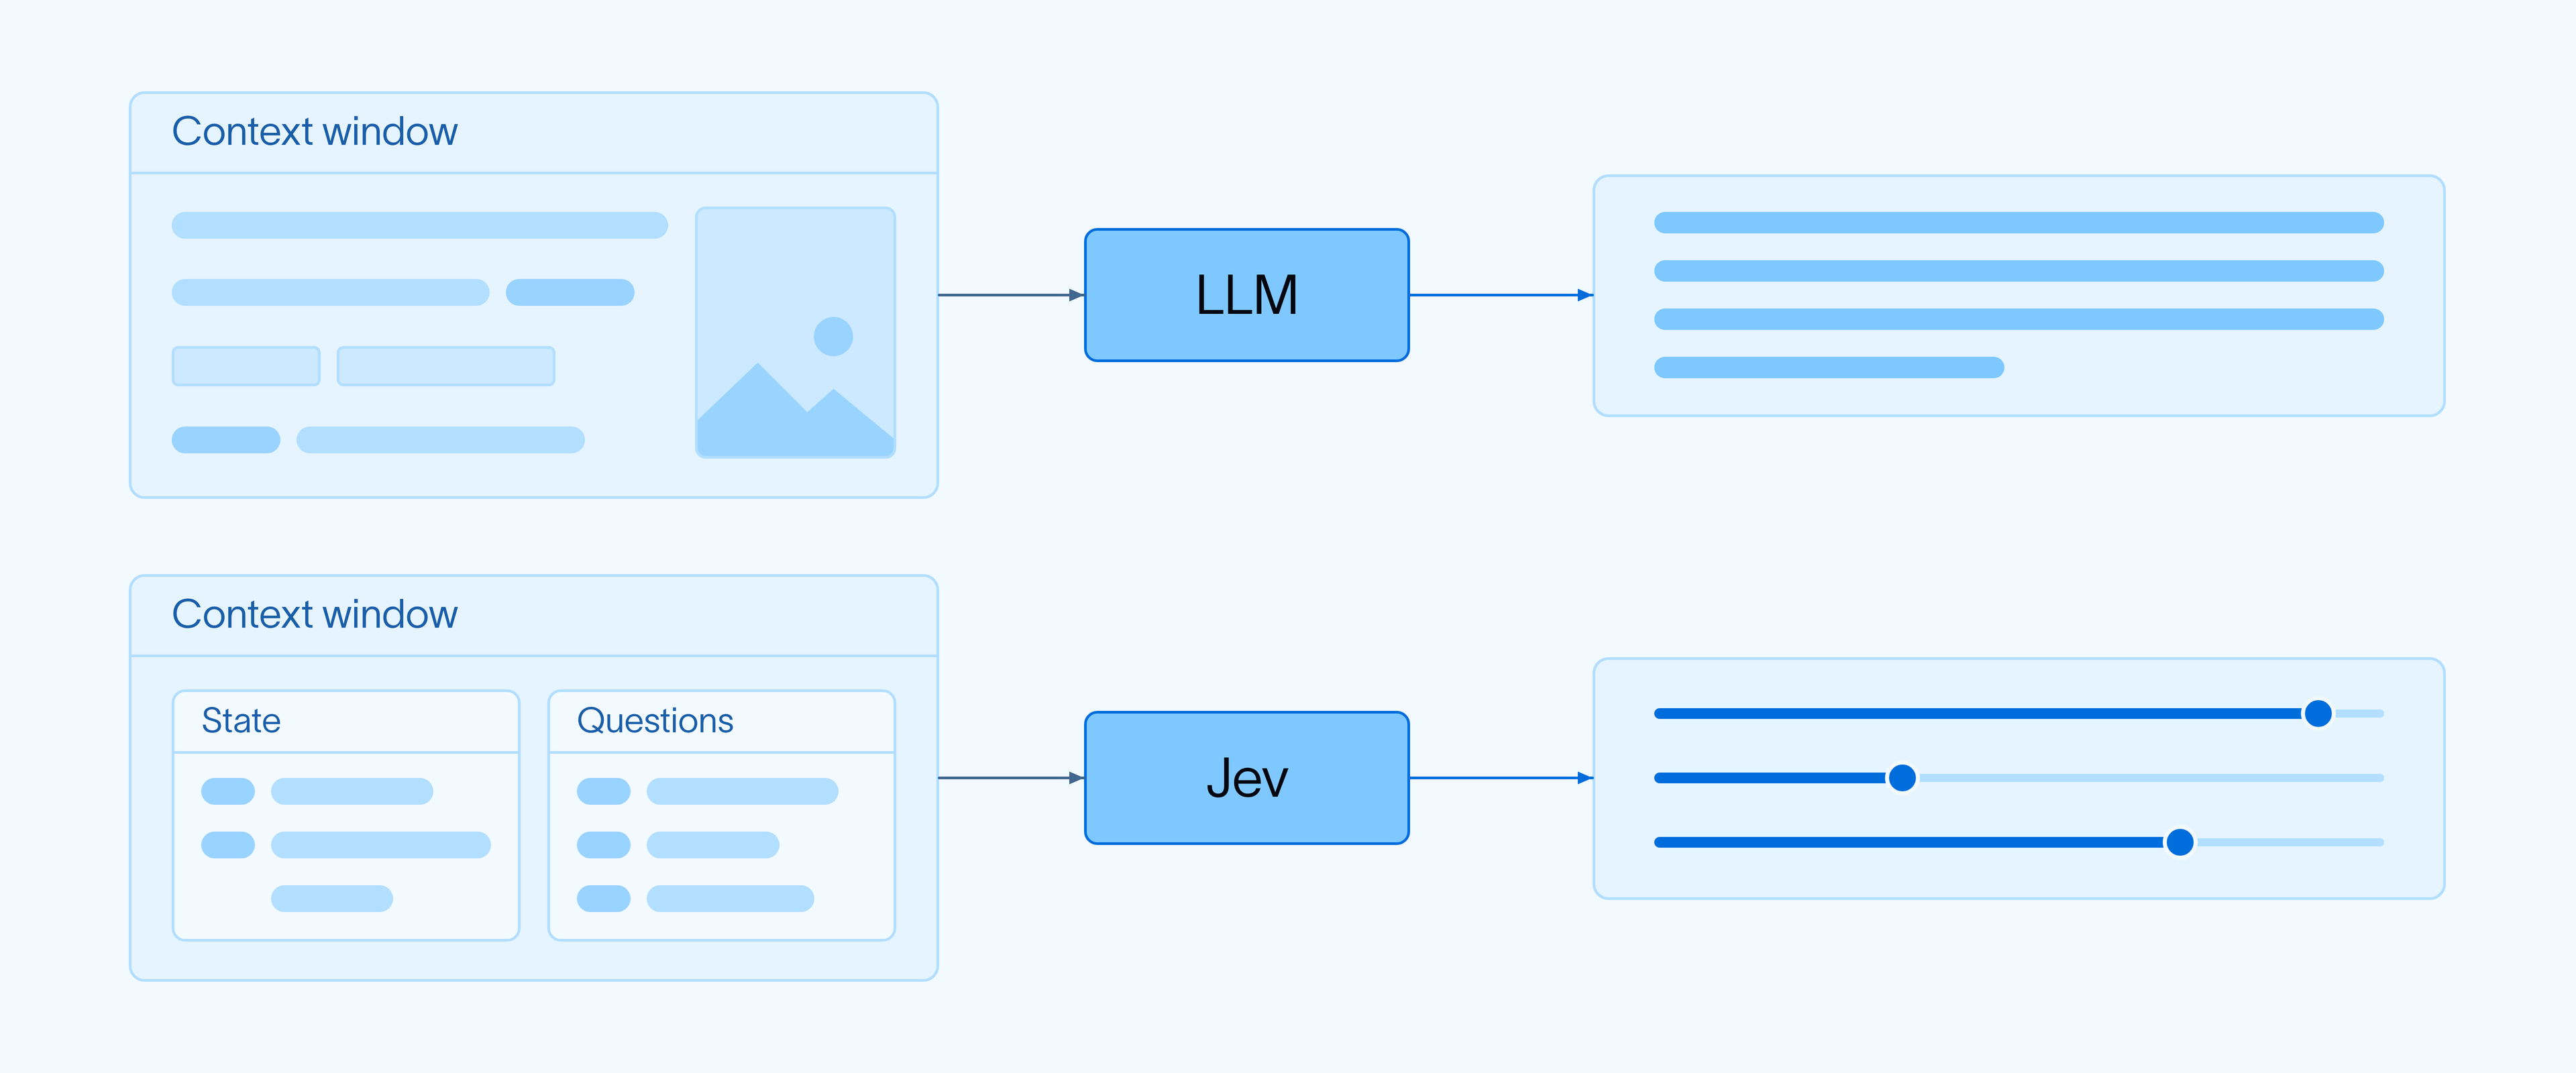
В запросе есть state — материал для оценки — и questions, словарь вопросов. По описанию состояния, state может быть строкой, объектом JSON или массивом. Для обращения достаточно текста письма; если решение зависит от заказа и правил возврата, эти сведения нужно передать вместе с ним.
Для текста используются три основных типа вопросов. Choice выбирает один вариант из списка, например billing, technical или other. Score оценивает данные по описанной словами шкале: «внешний дефект», «есть обходной путь», «работа заблокирована». Noul возвращает вероятность ответа «да» на конкретный вопрос, например «Клиент просит вернуть деньги?». Форматы приведены в справочнике примитивов.
У Choice и Score есть probabilities и confidence. У Noul отдельного confidence нет: значение около 0,5 означает неопределённость. Score может быть дробным; в шкале из трёх уровней результат лежит от 0 до 2, включая промежуточные значения.
Несколько вопросов в одном вызове оцениваются независимо по одному состоянию. Если второй вопрос должен учитывать ответ на первый, его нужно отправить следующим запросом. Добавьте в Choice вариант other для сообщений, которые не подходят ни одной категории или содержат слишком мало данных.
Как попробовать Jev без программирования
Откройте официальную консоль TypeSafe, войдите в аккаунт и перейдите в Playground. В поле state вставьте обезличенное сообщение, например: «С карты дважды списали оплату за один заказ. Прошу вернуть повторный платёж». Добавьте вопрос Noul: «Просит ли клиент вернуть деньги?» — и выполните запрос. Этот способ работы описан в Quick start.
Затем замените сообщение на «Где скачать счёт за прошлый месяц?» и сравните результаты. Добавьте Choice с вариантами «платежи», «техническая проблема» и «другое». Смотрите, как меняются вероятности, когда письмо короткое, двусмысленное или касается нескольких тем. Такие пробы помогают уточнить вопрос, но ещё не показывают качество на реальном потоке обращений.
Первый запрос к API из Node.js
Для приложения создайте API-ключ в консоли. Запросы отправляются на POST https://api.typesafe.ai/v1/systemone с заголовком Authorization: Bearer и ключом; тело содержит model, state и questions. Полная схема доступна в справочнике API. Ключ храните на сервере в переменной окружения, не включайте его в клиентский JavaScript.
Сохраните пример jev-route-ticket.mjs в отдельную папку. Понадобится Node.js 20 или новее, дополнительные пакеты не нужны. В терминале Bash или zsh задайте переменную командой export TYPESAFE_API_KEY='ваш-ключ', затем выполните node jev-route-ticket.mjs. В файле находятся текст обращения и Choice с четырьмя категориями; замените их на свои данные.
Пример выводит фактическую версию модели, выбранную категорию, вероятности и confidence. Если confidence ниже условного порога 0,8 или выбрано other, предложенный маршрут получает пометку review. Это учебный порог, который требуется подобрать по размеченным примерам. Скрипт выводит результат в терминал; подключение к системе поддержки нужно реализовать отдельно.
Запрос использует jev-latest. На 16 октября 2026 года таблица моделей TypeSafe связывает этот псевдоним со стабильной jev-1.13.0, а jev-preview — с jev-1.14.0. Версия 1.14 доступна с 14 октября. Для воспроизводимой проверки укажите конкретный идентификатор вместо меняющегося псевдонима. Пример подготовлен по документации; редакция не выполняла платный вызов Jev и не измеряла его точность или задержку.
Как писать вопросы и обрабатывать сомнительные ответы
Формулируйте одно проверяемое условие на вопрос. «Содержит ли письмо просьбу о возврате?» проще проверить, чем «Как лучше поступить с клиентом?». Опишите границы категорий: ошибка оплаты относится к billing, сбой интеграции — к technical. Важные сведения помещайте в state, а правила оценки — в instructions и criteria.
Confidence вычисляется из распределения вероятностей; это отдельная характеристика, а не гарантия верности ответа. Для спорных случаев предусмотрите передачу человеку или другому обработчику. Проверяйте выбранный порог на обычных обращениях, неполных сообщениях и примерах, где правильного варианта в списке нет.
Сохраняйте вместе с результатом версию модели и вопроса, чтобы понимать, после какого изменения появились ошибки. Для русского текста нужна отдельная выборка: TypeSafe указывает английский как основной язык обучения и сообщает о более низкой точности на других языках.
По теме: Как AI Gateway передаёт сомнительные решения другой модели
Цена, контекст и экспериментальная работа с изображениями
По спецификации TypeSafe, на 16 октября Jev 1.13 и 1.14 стоят 0,042 доллара за миллион входных токенов; выходные токены бесплатны. По умолчанию действуют два ограничения контекста: 64 тысячи токенов на весь запрос и 32 тысячи на состояние вместе с одним вопросом. Лимиты запросов и токенов в секунду зависят от организации и показываются в консоли. Бюджет проверяйте по фактическому расходу всего процесса, включая последующие вызовы LLM.
В Jev 1.14 есть экспериментальный тип Box: он ищет объект на изображении и возвращает координаты рамки. Для него нужны jev-preview или jev-1.14.0 и заголовок TypeSafe-Danger-Zone-Images: true. TypeSafe предупреждает, что изображения и Box пока предназначены для прототипов: формат, ограничения и точность могут меняться. Для первого проекта с текстовой классификацией эта возможность не требуется.
Где Jev может ошибаться
В перечне ограничений Jev 1.13, обновлённом 2 октября, TypeSafe описывает ошибки в арифметике и сравнении дат, буквальное понимание инструкций и ухудшение результатов при избытке нерелевантных данных. Там же отмечены чувствительность к порядку вариантов и уязвимость к специально подобранному содержимому. Эти наблюдения относятся к 1.13; автоматически переносить их как результаты теста 1.14 нельзя.
Поэтому суммы, сроки и права доступа проверяйте программно. Jev можно поручить смысловую классификацию, а решение о допустимости действия оставить правилам приложения. Предсказуемая структура ответа облегчает интеграцию, но ошибочный выбор категории всё равно остаётся ошибкой. Перед автоматической обработкой обращений проверьте, сколько неверных назначений проходит выбранный порог и сколько сообщений уходит на ручную проверку.
По теме: Clef и Clef-flash: открытые модели решений Cloudflare