Вайбкодинг · 3 октября 2026 г.
Ускорьте работу интерактивных агентов с GPT-6 Astra Ultrafast
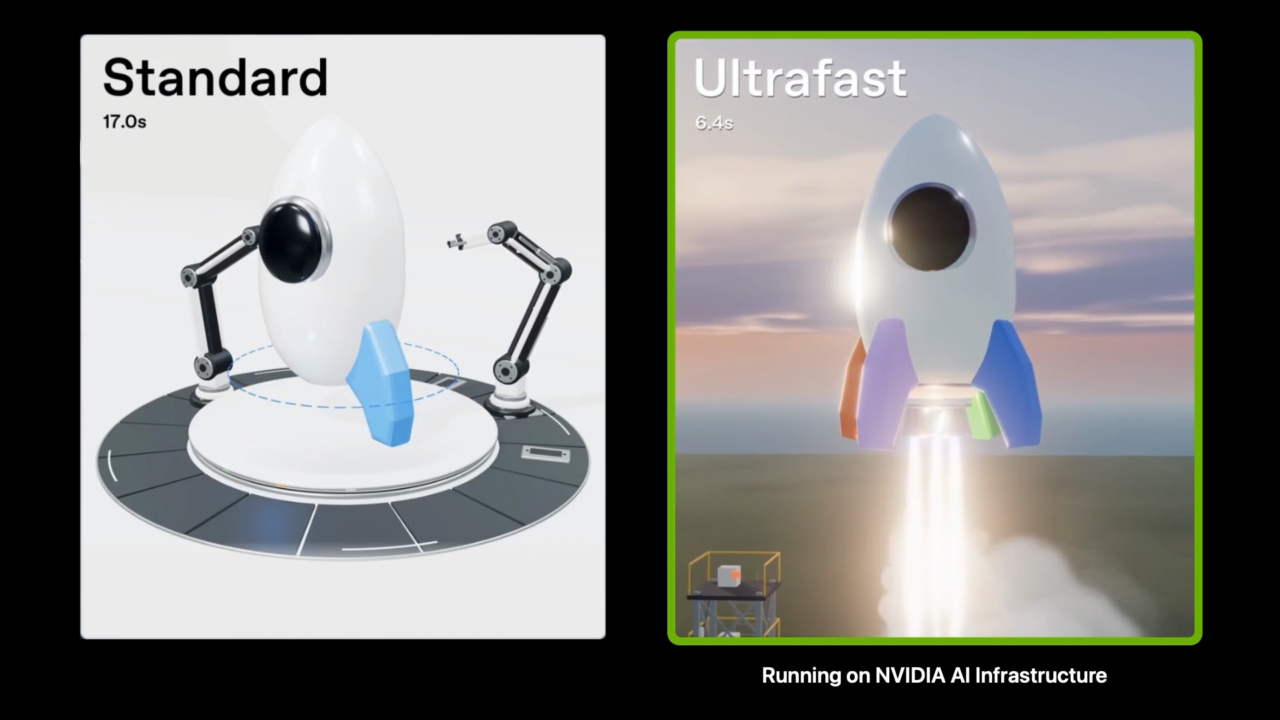
OpenAI предлагает GPT-6 Astra Ultrafast на NVIDIA Blackwell GPUs: до 8× быстрее генерация токенов, что сокращает задержки в циклах редактирования, вызовов инструментов и интерактивных приложениях.
Лид — зачем разработчикам это важно
GPT-6 Astra Ultrafast теперь работает на NVIDIA Blackwell GPUs и доступен через OpenAI API и для подходящих пользователей ChatGPT Work и Codex. По данным источника, Ultrafast даёт до 8× более быструю генерацию токенов по сравнению с Astra Standard. Под «генерацией токенов» понимают поэтапное построение текста моделью — чем быстрее модель генерирует токены, тем короче внешняя задержка (latency) и отклик приложения.
Для разработчиков это прямо переводится в ускорение критичных циклов: агент пишет код, вызывает инструмент, получает результат и решает следующий шаг. Если каждая итерация заметно короче, то редактирование, тестирование и отладка происходят быстрее, а интерактивные интерфейсы становятся более отзывчивыми.
Как устроено ускорение и что изменилось
Ускорение достигается сочетанием аппаратной архитектуры NVIDIA Blackwell и программных оптимизаций инференса, которые OpenAI применил к своим моделям. В публикации подчёркивается, что платформа NVIDIA программируемая: это позволяет создавать специализированные ядра (kernels) и оптимизации, которые лучше используют возможности чипов для задач низкой задержки и высокой пропускной способности.
OpenAI использует собственные модели для оптимизации инференс-софта на NVIDIA-оборудовании. То есть не только аппарат ускоряет расчёты, но и модельный стек помогает выявлять и внедрять улучшения в runtime. Такой цикл «модель помогает оптимизировать инференс, инференс даёт ускорение моделям» служит источником непрерывного прироста производительности после развёртывания.
Программируемость платформы важна ещё и потому, что она облегчает повторное использование инфраструктуры между задачами: обучение, инференс и обучение с подкреплением (reinforcement learning). Это даёт организациям гибкость перераспределять вычислительные ресурсы по мере смены нагрузки и снижать избыточное резервирование.
Практические последствия для разработки агентов и приложений
Короткие задержки и более быстрая генерация токенов наиболее заметны в сценариях с множественными последовательными шагами: автоматические кодогенераторы, агенты, которые обращаются к внешним инструментам, и интерактивные помощники. В таких потоках ускорение отклика складывается, сокращая общее время на цикл «сгенерировать — выполнить — проанализировать — сгенерировать снова». Это повышает скорость итераций при отладке и улучшает качество обратной связи в реальном времени для пользователей.
Также заявлена выгода по использованию инфраструктуры: с помощью программируемых оптимизаций команды могут лучше измерять и повышать эффективность кластеров, перераспределять ресурсы между обучением и инференсом и тем самым уменьшать расходы, связанные с простаиванием оборудования. В публикации отмечают, что эти изменения делают оборудование более «компендибельным» для разных типов нагрузки.
Наконец, сами разработчики получают доступ к Ultrafast через API, что упрощает внедрение в существующие пайплайны. Для использования доступных конфигураций и деталей интеграции OpenAI предлагает руководство Ultrafast с информацией по доступу и имплементации.
Доступ и внедрение
По данным материала, GPT-6 Astra Ultrafast уже доступен в OpenAI API и разрешён некоторым пользователям ChatGPT Work и Codex. Для внедрения нужно учитывать платформенные требования и рекомендации по оптимизации, которые публикуют OpenAI и NVIDIA. Подробности по доступу, ценообразованию и практическим шагам по интеграции находятся в руководстве Ultrafast.
Для команд, которые уже оперируют в облаке или на собственных кластерах с поддержкой NVIDIA, основной путь — оценить совместимость текущих пайплайнов инференса с Blackwell-оптимизациями и пройти процесс тестирования рабочих нагрузок, чтобы понять, как ускорение проявится в их конкретных сценариях.
Ограничения и что важно учесть
Заявленное ускорение — «до 8×» по сравнению с Astra Standard — означает пиковый показатель; фактическая выгода зависит от характера нагрузки, длины и сложности запросов, а также от того, как именно настроены инференс-пайплайны. Нельзя автоматически ожидать восьмикратного ускорения во всех сценариях.
Оптимизации требуют работы с платформой и возможной переработки инференс-стека: создание или адаптация специализированных ядер, тестирование производительности и контроль за использованием ресурсов. Это подразумевает дополнительные инженерные усилия и знания о низкоуровневой оптимизации под конкретную архитектуру.
Доступность функции распределена: Ultrafast доступен через API и «eligible» для пользователей ChatGPT Work и Codex, но это не значит, что у всех автоматом появится доступ к нужным конфигурациям. Вопросы доступа и ценообразования решаются отдельным образом, подробности — в руководстве.
Наконец, постоянное улучшение инференса означает, что поведение системы может меняться со временем: апдейты могут повышать производительность, но также требуют мониторинга и возможной адаптации вашего кода и инфраструктуры.
Короткая инструкция для оценки
1) Протестируйте Ultrafast через OpenAI API на репрезентативных рабочих нагрузках, чтобы сравнить реальное ускорение с Astra Standard. 2) Измерьте не только среднюю латентность, но и влияние на end-to-end циклы агентов (серии вызовов и инструментов). 3) Оцените инженерные затраты на интеграцию специфичных оптимизаций и сопоставьте с ожидаемой экономией времени и ресурсов. 4) Следите за обновлениями от OpenAI и NVIDIA: оптимизации продолжаются, и поведение может улучшаться после начального развёртывания.